 zhe, zhuo
轻量级单阶段目标检测系统-python+Keras
基于 Keras 的轻量级单阶段目标检测系统
一、项目描述
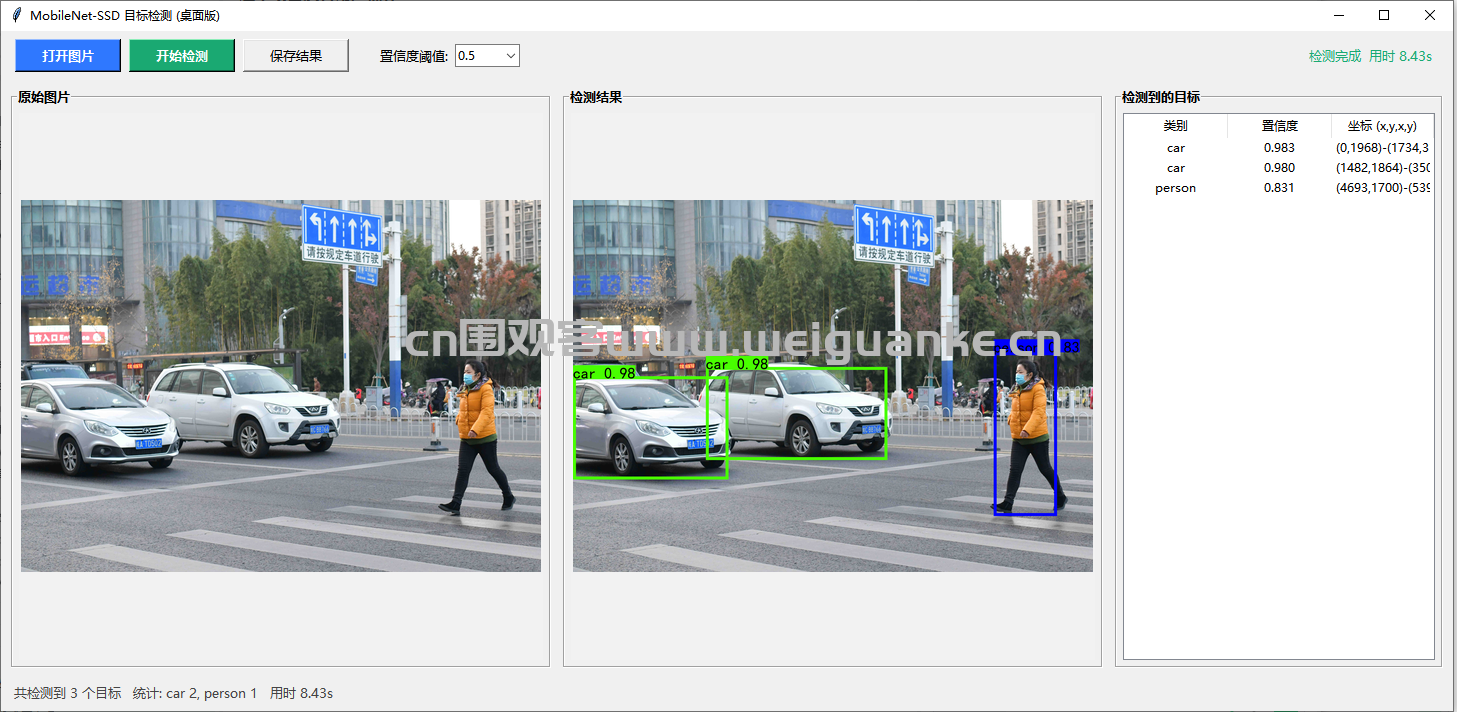
本项目是 Mobilenet-SSD-Essay,一个基于 Keras 的轻量级单阶段目标检测系统。它的作用是:输入一张图片或一段视频,自动找出画面中每个物体的类别、位置和置信度,并用彩色矩形框把结果画出来。项目基于 MobileNet 作为主干特征提取网络、SSD 多尺度检测头进行预测,模型小、推理快,既能在 CPU 上直接运行预训练权重,也能用 VOC 格式数据重新训练自己的目标类别。
二、项目功能
项目提供三种使用方式。第一种是训练功能,通过 train.py 进行冻结加解冻两阶段训练,自动保存权重到 logs 目录。第二种是命令行预测功能,通过 predict.py 支持四种模式:单张图片交互式检测、整个文件夹批量检测并保存、摄像头或本地视频实时检测、FPS 吞吐速度测试。第三种是桌面图形界面,通过本次新增的 predict_gui.py,用户无需敲命令,直接点按钮打开图片、调置信度阈值、一键检测、保存结果图,并可在右侧列表里看到每个目标的类别、分数和像素坐标。除此之外,还附带 voc_annotation.py 用来把 VOC 格式 XML 自动划分训练集验证集并生成训练清单,以及 get_map.py 用来在测试集上跑 mAP 评估。
三、运行环境
本项目当前运行在 Windows 10 64 位系统上,Python 版本 3.13.5,由 Anaconda 管理环境。深度学习框架使用 TensorFlow 2.21.0,并通过 tf_keras 2.21.0 适配层提供兼容的旧 Keras 2.x 接口(启动时必须设置 TF_USE_LEGACY_KERAS=1)。其他依赖包括 NumPy 2.1.3、OpenCV 4.13.0 用于视频和色彩空间转换、Pillow 10.4.0 用于图片读写和画框、tkinter 作为桌面 GUI 的内置库,无需额外安装。需要注意 TensorFlow 2.11 以后官方在原生 Windows 上已经不支持 CUDA GPU,因此当前实际为纯 CPU 运行,如果想用显卡加速请改用 TF-DirectML 插件或迁移到 WSL2。
四、项目技术
模型结构方面,主干是 MobileNet V1,采用深度可分离卷积(DepthwiseConv2D 加 1×1 点卷积)在精度和速度之间做平衡;检测头是原版论文 SSD 结构,在 6 层不同尺度的特征图上分别做分类和边框回归,对应 7 组不同大小的先验框 anchors(30、60、111、162、213、264、315)。训练方面,损失函数采用 MultiboxLoss,由边框回归的 L1 平滑损失和分类的 Softmax 交叉熵组成,并通过 Hard Negative Mining(负正比 3:1)解决背景样本过多的问题;优化器默认 SGD 加动量 0.937,学习率用余弦余弦退火或阶梯衰减,训练分两阶段(冻结阶段训练检测头、解冻阶段微调全网络),所有卷积和全连接层附加 L2 正则化防止过拟合。推理方面,先做原图 300×300 的预处理,再经过模型预测解码把先验框偏移量还原为图像坐标,用 0.5 的置信度阈值过滤低分框,再用 IoU 0.45 的 NMS 非极大值抑制去掉重叠框,最后在图上绘制彩色矩形框、类别名和置信度。整个代码已经完成了 TensorFlow 2.x 的全面兼容迁移,把旧 Keras 导入、旧 tf.log/tf.to_float 类型转换、旧 keras add_loss 签名、旧 textsize Pillow API、旧 multi_gpu_model 等都做了对应替换。
五、数据集
本项目使用的数据集是 PASCAL VOC 2007 加 VOC 2012 合并版,总共有 21504 张彩色 JPG 图片,大小约 2.06GB,配套 21503 份 XML 标注文件,存放在项目根目录的 VOCdevkit/VOC2007/ 下的 JPEGImages 和 Annotations 文件夹。数据集采用标准 9:9:82 比例划分(trainval_percent=0.9、train_percent=0.9),其中训练集 17416 张、验证集 1936 张、测试集 2151 张,已通过 voc_annotation.py 生成 2007_train.txt 和 2007_val.txt 两个训练清单,每行包含一张图片的绝对路径以及图中所有目标的 xmin、ymin、xmax、ymax 和类别编号。数据集一共包含 20 个检测类别,分别是飞机、自行车、鸟、船、瓶子、公交车、轿车、猫、椅子、奶牛、餐桌、狗、马、摩托车、人、盆栽、羊、沙发、火车、电视,总共标注了 41500 个目标框,其中 person 人物类数量最多(16051 个),其余每类大约在 900 到 4000 之间,适合典型的街景通用目标检测场景。
以上系统源码经过技术整理与调试,确保能正常运行