 zhe, zhuo
基于 3D-Speaker 声纹模型的 RESTful API 服务-python+D-Speaker
项目描述 基于 3D-Speaker 声纹模型的 RESTful API 服务
基于 3D-Speaker 声纹模型的 RESTful API 服务,提供说话人声纹注册、全库自动识别、注册记录管理与删除功能,内置可视化 Web 操作界面。
户操作界面:http://localhost:8005/ui
API 文档(Swagger):http://localhost:8005/voiceprint/docs
健康检查:http://localhost:8005/voiceprint/health?key=858b2821-5aab-47e7-a7d6-af10f2a0a553
API Token:858b2821-5aab-47e7-a7d6-af10f2a0a553
项目功能
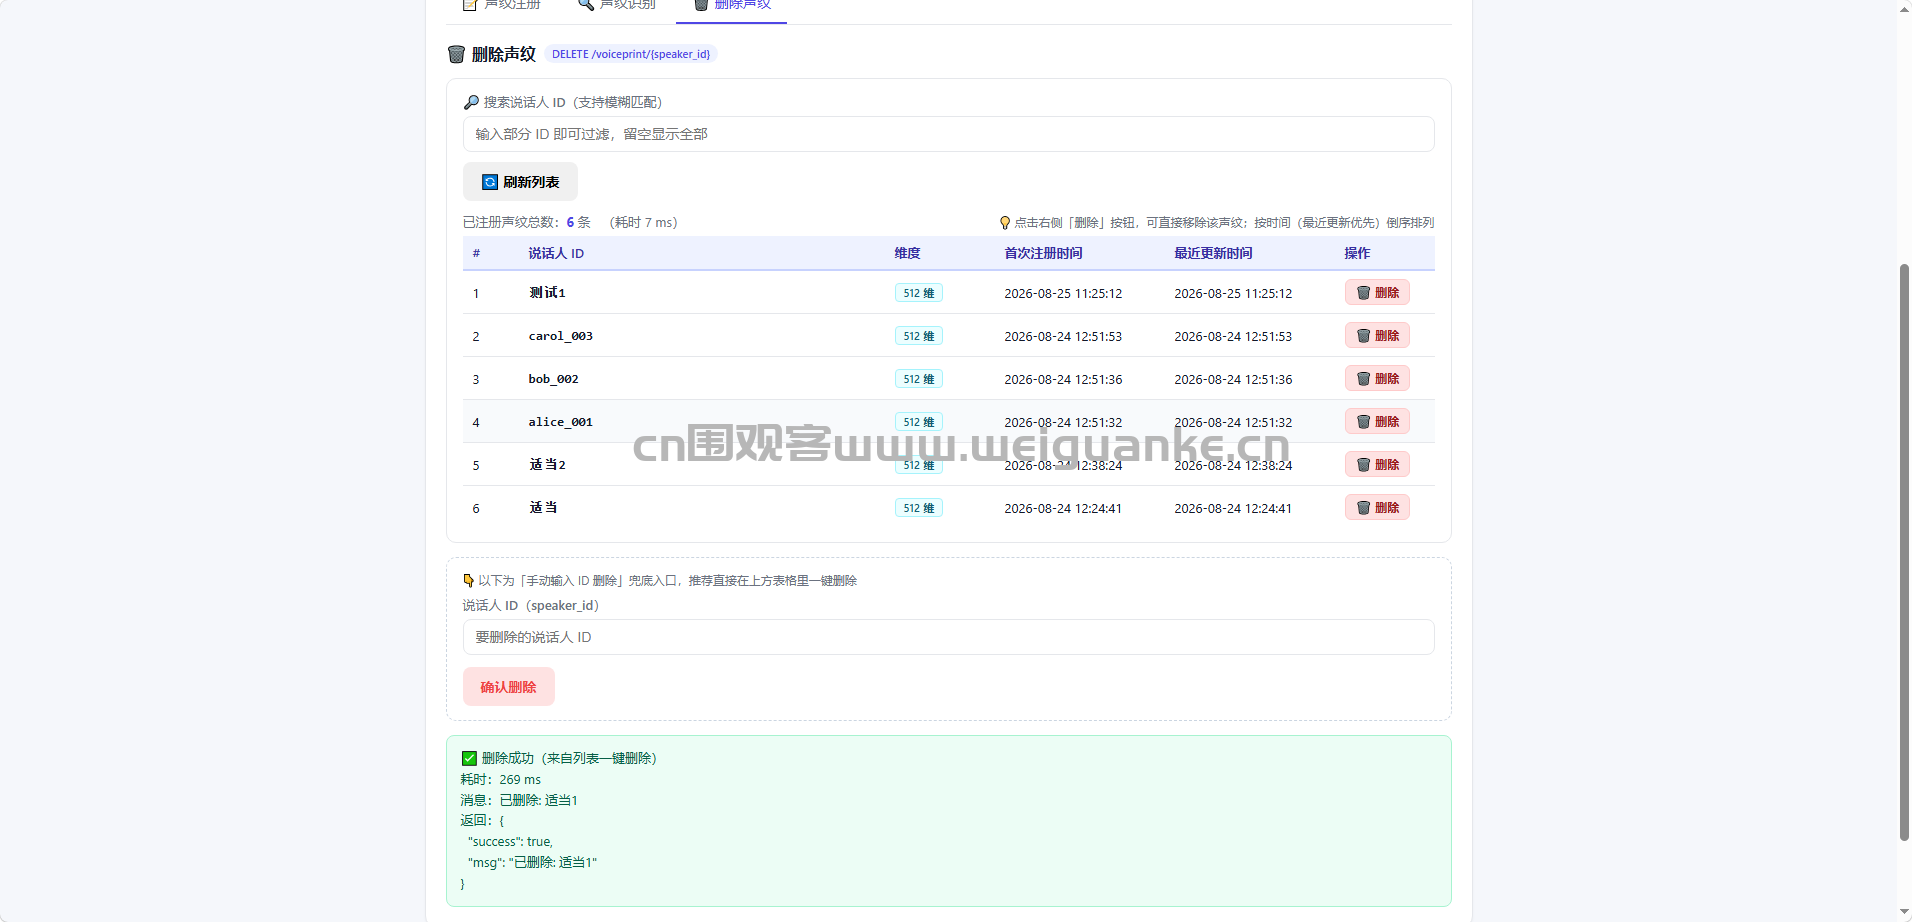
声纹注册:上传 WAV 音频 + 说话人 ID,提取声纹特征存入数据库 声纹识别:上传 WAV 音频,无需指定候选 ID,自动在全部已注册声纹中比对,返回最佳匹配说话人、相似度分数、阈值判定及候选排行 注册记录列表:分页列出所有已注册说话人,含 ID、特征维度、注册时间,支持模糊搜索 删除声纹:在记录列表中一键删除,或手动输入 ID 删除 健康检查:验证服务状态及已注册声纹总数 可视化界面:Token 自动注入、三选项卡操作(注册/识别/删除)、结果可视化展示
运行环境
操作系统:Windows Python:3.x(Anaconda 环境) 数据库:MySQL 5.7+(127.0.0.1:3306,库名 voiceprint_db,账号 root/root) 模型:iic/speech_campplus_sv_zh-cn_3dspeaker_16k(ModelScope 自动下载至本地缓存) 启动命令:python -m uvicorn app.application:app –host 0.0.0.0 –port 8005 –workers 1 访问入口:http://localhost:8005/ui (界面)/ http://localhost:8005/voiceprint/docs (API 文档)
项目技术
后端框架:FastAPI + Uvicorn(异步 Web 框架) 声纹模型:ModelScope 3D-Speaker CAM++(speaker_verification 任务),CPU/GPU 自适应 音频处理:librosa(重采样至 16kHz)、soundfile、torchaudio 特征计算:NumPy 余弦相似度 数据库:PyMySQL(voiceprints 表,字段含 speaker_id/feature_vector/created_at/updated_at) 配置管理:PyYAML(voiceprint.yaml),启动时自动生成 API Token(UUID4) 日志:Loguru 前端:纯 HTML/CSS/JS 单页(无构建依赖),Token 服务端注入、localStorage 持久化、fetch + Bearer 认证
以上系统源码经过技术整理与调试,确保能正常运行