 zhe, zhuo
基于PyTorch实现的语音情感识别系统-python
项目描述 基于 PyTorch 实现的语音情感识别系统
基于 PyTorch 实现的语音情感识别系统。核心思路是用 emotion2vec 提取语音的情感特征,再接一个 BiLSTM 分类网络输出情感类别;同时也支持直接调用 ModelScope 上的 emotion2vec 预训练模型做端到端识别。项目原本是纯命令行工具,现已新增一个桌面图形界面。
项目功能
音频情感识别:输入一段语音,输出情感标签(如生气、开心、悲伤等)和置信度得分。
两种识别方式:直接使用 ModelScope 预训练模型(seed / base / large 三档,开箱即用);或使用自建 BiLSTM 模型(需自行准备数据集并训练)。
命令行流程:create_data.py 生成数据列表与归一化文件、train.py 训练、eval.py 评估、infer.py 推理。
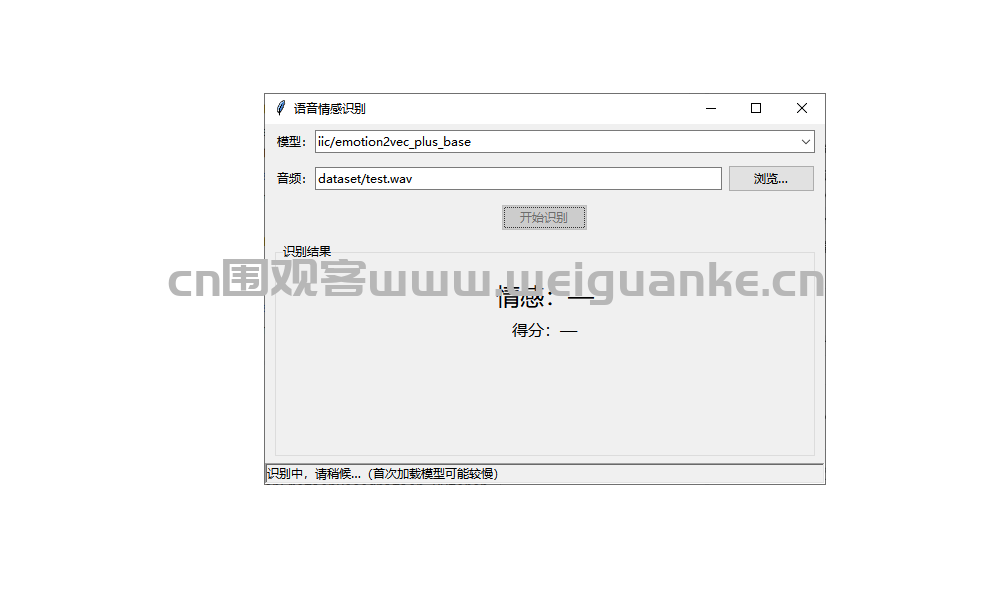
桌面界面(gui.py):选择模型 → 选择/浏览音频文件 → 一键识别,结果与得分直接显示;预测在后台线程执行不卡界面,模型加载后缓存复用,并自动适配 CPU/GPU。
运行环境
Windows 10;Python 3.13;PyTorch 2.13(本机为 CPU 版,无 CUDA,运行时需 use_gpu=False)。依赖 ModelScope、FunASR、yeaudio 等;图形界面基于 Python 内置的 tkinter,无需额外安装。ModelScope 预训练模型首次运行时自动下载并缓存到本地 models/ 目录。
项目技术
PyTorch 深度学习框架;emotion2vec 语音情感特征提取 + BiLSTM 分类网络;ModelScope / FunASR 提供预训练模型与推理支持;yeaudio、pydub、resampy 等做音频读取与重采样;YAML 配置文件管理训练与模型参数;tkinter 实现桌面图形界面。
以上系统源码经过技术整理与调试,确保能正常运行