 zhe, zhuo
北京市二手房数据分析与房价预测系统-随机森林
项目描述 北京市二手房数据分析与房价预测系统
本项目是一套北京市二手房数据分析与房价预测系统,面向东城区、海淀区、通州区、怀柔区四个城区,以安居客挂牌房源为数据来源,完成从数据采集、清洗、统计分析、可视化到机器学习建模预测的完整流程,并提供仪表盘与在线预测两个网页页面。
项目功能
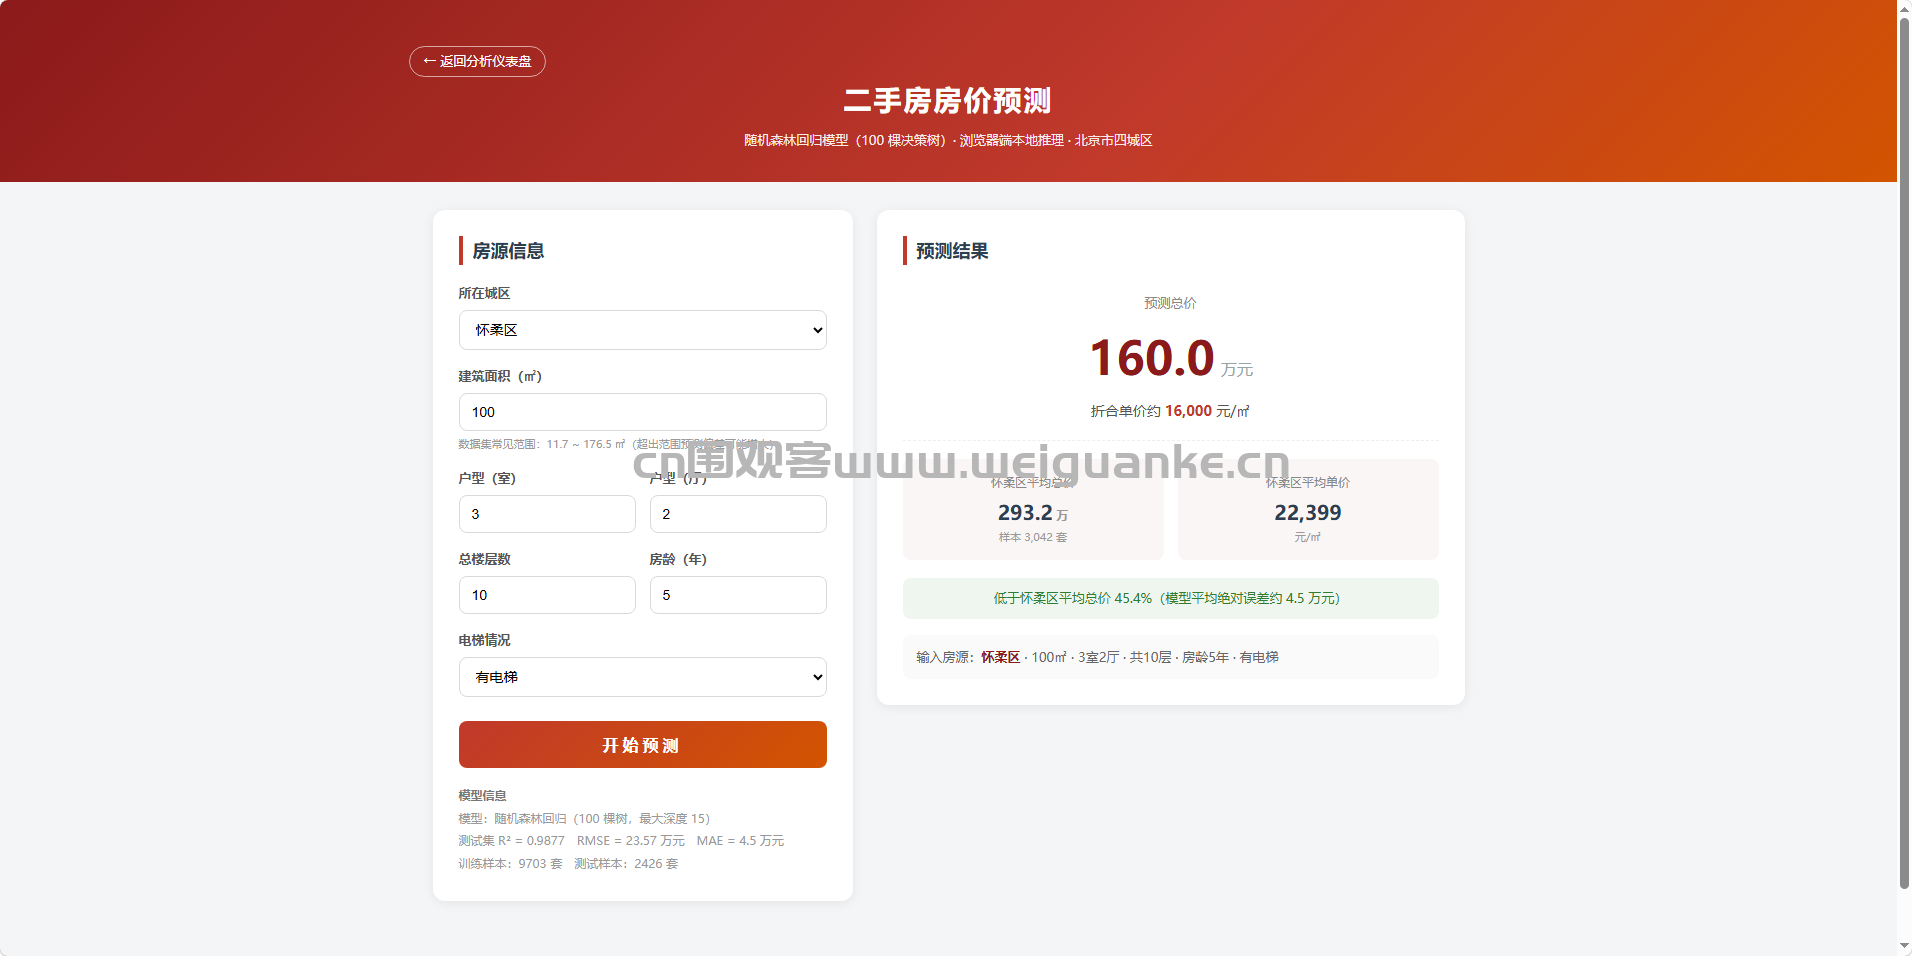
数据采集:自动爬取房源列表与详情信息,内置随机延时、User-Agent 轮换、失败重试与断点续爬。数据预处理:完成去重、缺失值处理、字段类型转换和异常值检测过滤,将 12171 条原始数据清洗为 12129 条结构化数据。统计分析:从总价、单价、户型、楼层、面积、建筑年代、电梯七个维度进行分组统计并生成图表。因素分析:分析面积与价格的关系及多因素相关性。热力图:在地图上呈现四个城区单价与总价的空间分布,支持交互式 HTML 与静态图。房价预测:训练线性回归与随机森林两种模型,随机森林 R² 达 0.9877。网页功能:dashboard.html 汇总核心指标、城区对比表和全部分析图表;predictor.html 支持填写房源信息在线预测总价与单价,并与城区均价对比。同时提供 Python 端预测接口供二次调用。
运行环境
操作系统为 Windows,Python 3.8 及以上版本(实测 Anaconda Python 3.14 可运行)。依赖 pandas、numpy、matplotlib、seaborn、scikit-learn、requests、beautifulsoup4、lxml、joblib;folium 为可选项,未安装时自动降级为静态热力图。网页页面为纯静态文件,用浏览器直接打开或通过本地 HTTP 服务访问即可,无需数据库和后端服务。
项目技术
采集层使用 requests 配合 BeautifulSoup、lxml 解析移动端网页;数据处理使用 pandas 与 numpy;统计可视化使用 matplotlib 与 seaborn;地理可视化使用 folium(Leaflet);建模使用 scikit-learn 的线性回归、随机森林回归及 StandardScaler;模型通过 joblib 持久化,并将随机森林的 100 棵决策树序列化为紧凑 JSON 内嵌网页,由原生 JavaScript 在浏览器端逐树真实推理;前端页面采用原生 HTML、CSS、JavaScript 单文件实现,图表以 base64 内嵌,可完全离线打开和分享。
以上系统源码经过技术整理与调试,确保能正常运行