 zhe, zhuo
基于Spark分布式计算的医疗大数据分析平台-Spark
基于 Spark 分布式计算的医疗大数据分析平台
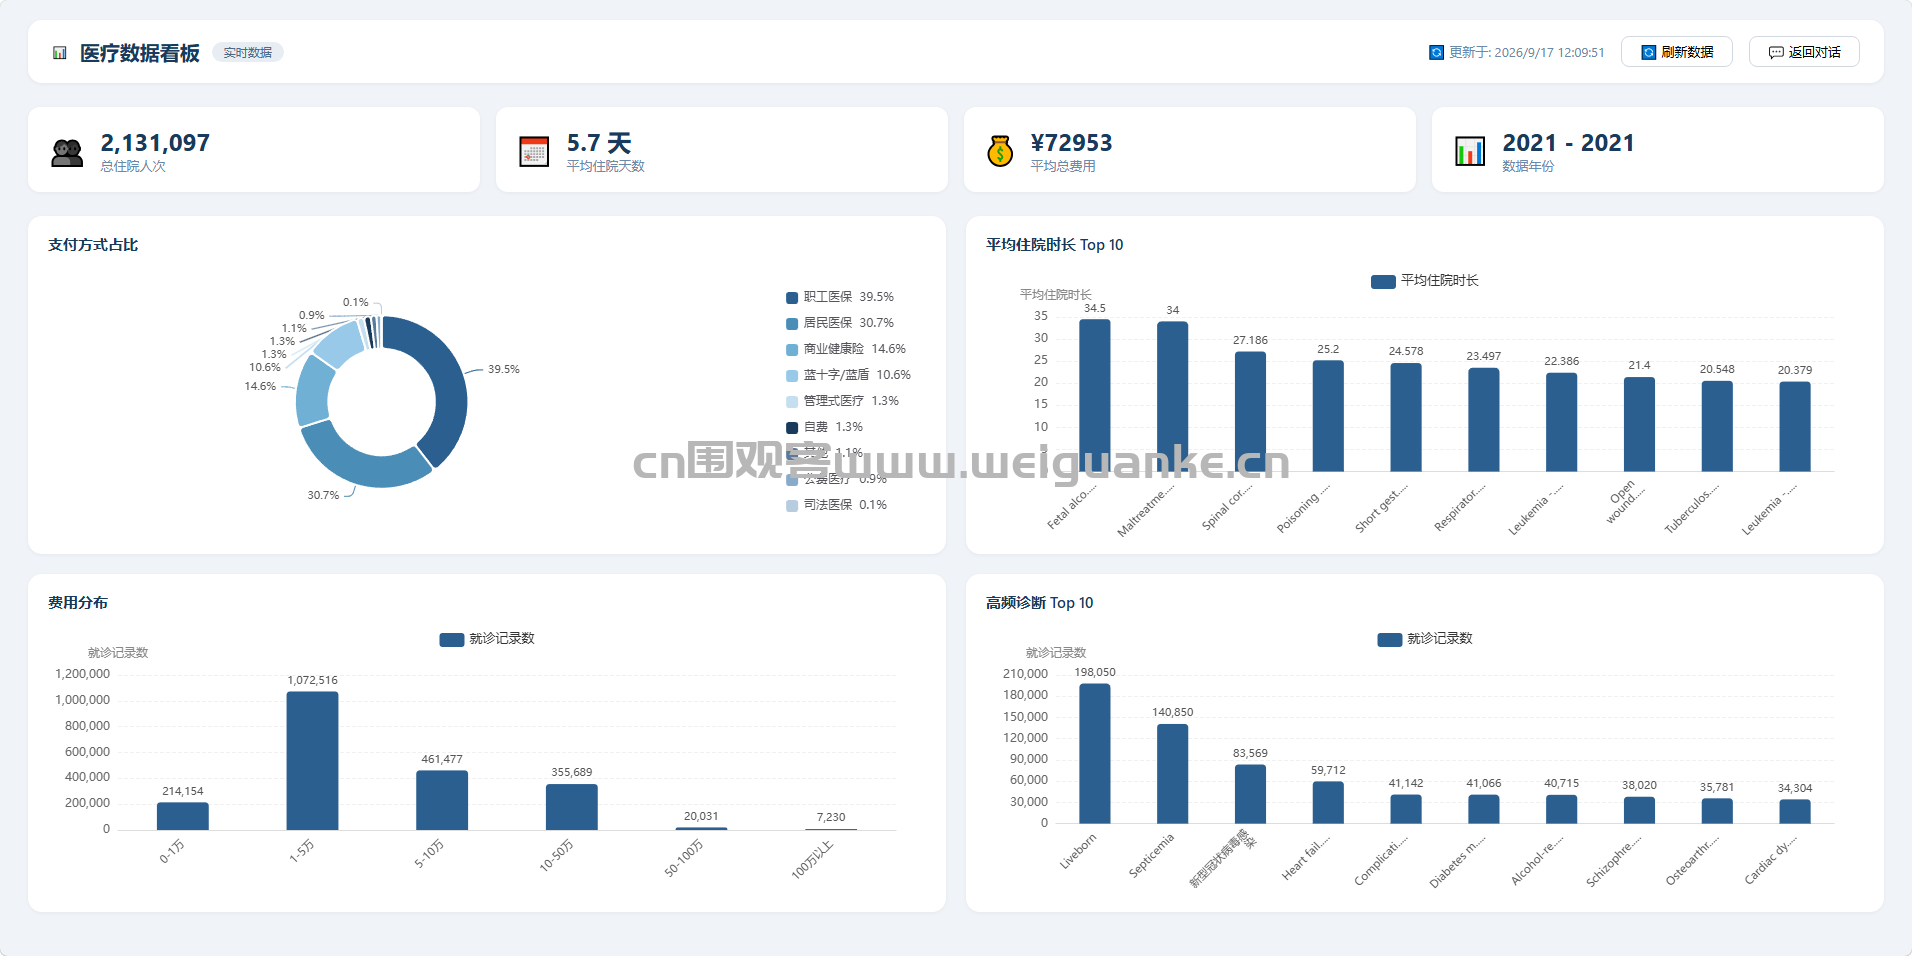
项目描述 :本项目是一个基于 Spark 分布式计算的医疗大数据分析平台,以美国纽约州 SPARCS 2021 住院出院数据集(约 213 万条)为数据源,覆盖数据预处理、分布式计算、后端接口、AI 智能问答和前端可视化全链路,形成”数据入湖—批量分析—接口服务—智能交互—图表呈现”的完整闭环。
项目功能 :数据端通过 ETL 完成 CSV 清洗、质量校验与 MySQL 入库;计算端基于 Spark 提供多维度聚合、平均住院时长、费用分布、年度趋势、支付占比、异常检测(Z-Score)、疾病关联规则(Apriori)和再入院风险(逻辑回归)等分析能力;后端以 RESTful API 对外统一暴露并支持缓存与降级;AI 模块基于 LangGraph 智能体调用大模型,支持自然语言提问、多轮对话和图表自动生成;前端提供数据看板和 AI 对话两类页面,以 ECharts 渲染柱状图、饼图、折线图等可视化结果。
运行环境 :Windows 操作系统,Python 3.11、JDK 11、Node.js(含 npm)、MySQL 8.0,计算层依赖 Spark 3.5(单机 local 模式即可运行),可选 Redis 做接口缓存,AI 模块通过 OpenAI 兼容协议接入智谱 GLM 大模型云端 API,无需本地 GPU。
项目技术 :后端使用 Python + Flask + PySpark + SQLAlchemy + MySQL;计算算法使用 Spark DataFrame、MLlib 与 scikit-learn;AI 交互使用 FastAPI + LangChain/LangGraph + 智谱 GLM-4-Air;前端使用 Vue 3 + TypeScript + Vite + Pinia + ECharts + Axios;工程上采用多模块独立部署、REST 接口解耦、Parquet 列式存储加速、Redis 缓存与统一响应封装,并配套 pytest 单元测试。
以上系统源码经过技术整理与调试,确保能正常运行