 zhe, zhuo
B站热门视频与评论情感分析-KNN、逻辑回归、随机森林、XGBoost、朴素贝叶斯、SVM
项目描述 B站热门视频与评论情感分析
本项目以 B 站「入站必刷」热门视频为研究对象,完成从数据采集到可视化呈现的完整数据分析链路。通过爬虫采集 98 个热门视频及其评论区热度前 100 条评论(共 9700 条),经清洗、脱敏与人工情感标注后得到 9061 条建模样本,在此基础上开展视频互动规律分析、评论情感三分类建模与评论主题聚类,并搭建 Web 展示页集中呈现分析成果与在线预测能力。
浏览器访问 http://127.0.0.1:5000
项目功能
视频指标分析:从播放、点赞、投币、收藏、分享、评论六个维度构造互动率衍生指标,输出 10 张可视化图表揭示流量与互动规律。评论情感分类:对比 KNN、逻辑回归、随机森林、XGBoost、朴素贝叶斯、SVM 六种模型,逻辑回归最优(测试集准确率 0.6702、macro-F1 0.63)。评论主题聚类:挖掘出玩梗打卡、长篇感想、视频内容评价、弹幕礼仪、UP 主互动 5 个主题簇。Web 展示页:集成 17 张图表、模型对比结论与评论情感在线预测功能,输入任意评论即可实时返回情感极性。
运行环境
Windows 操作系统,Python 3.11+(开发环境 3.12.3),依赖见 requirements.txt;词云图需脚本目录下存在 simhei.ttf 中文字体文件(Windows 可从系统字体目录复制)。数据、预测模型(评论情感分类.pkl,约 21 MB)随仓库发布,克隆后安装依赖即可运行,无需额外下载数据集或模型;Web 展示页通过 cd web && python app.py 启动,浏览器访问 http://127.0.0.1:5000 。
项目技术
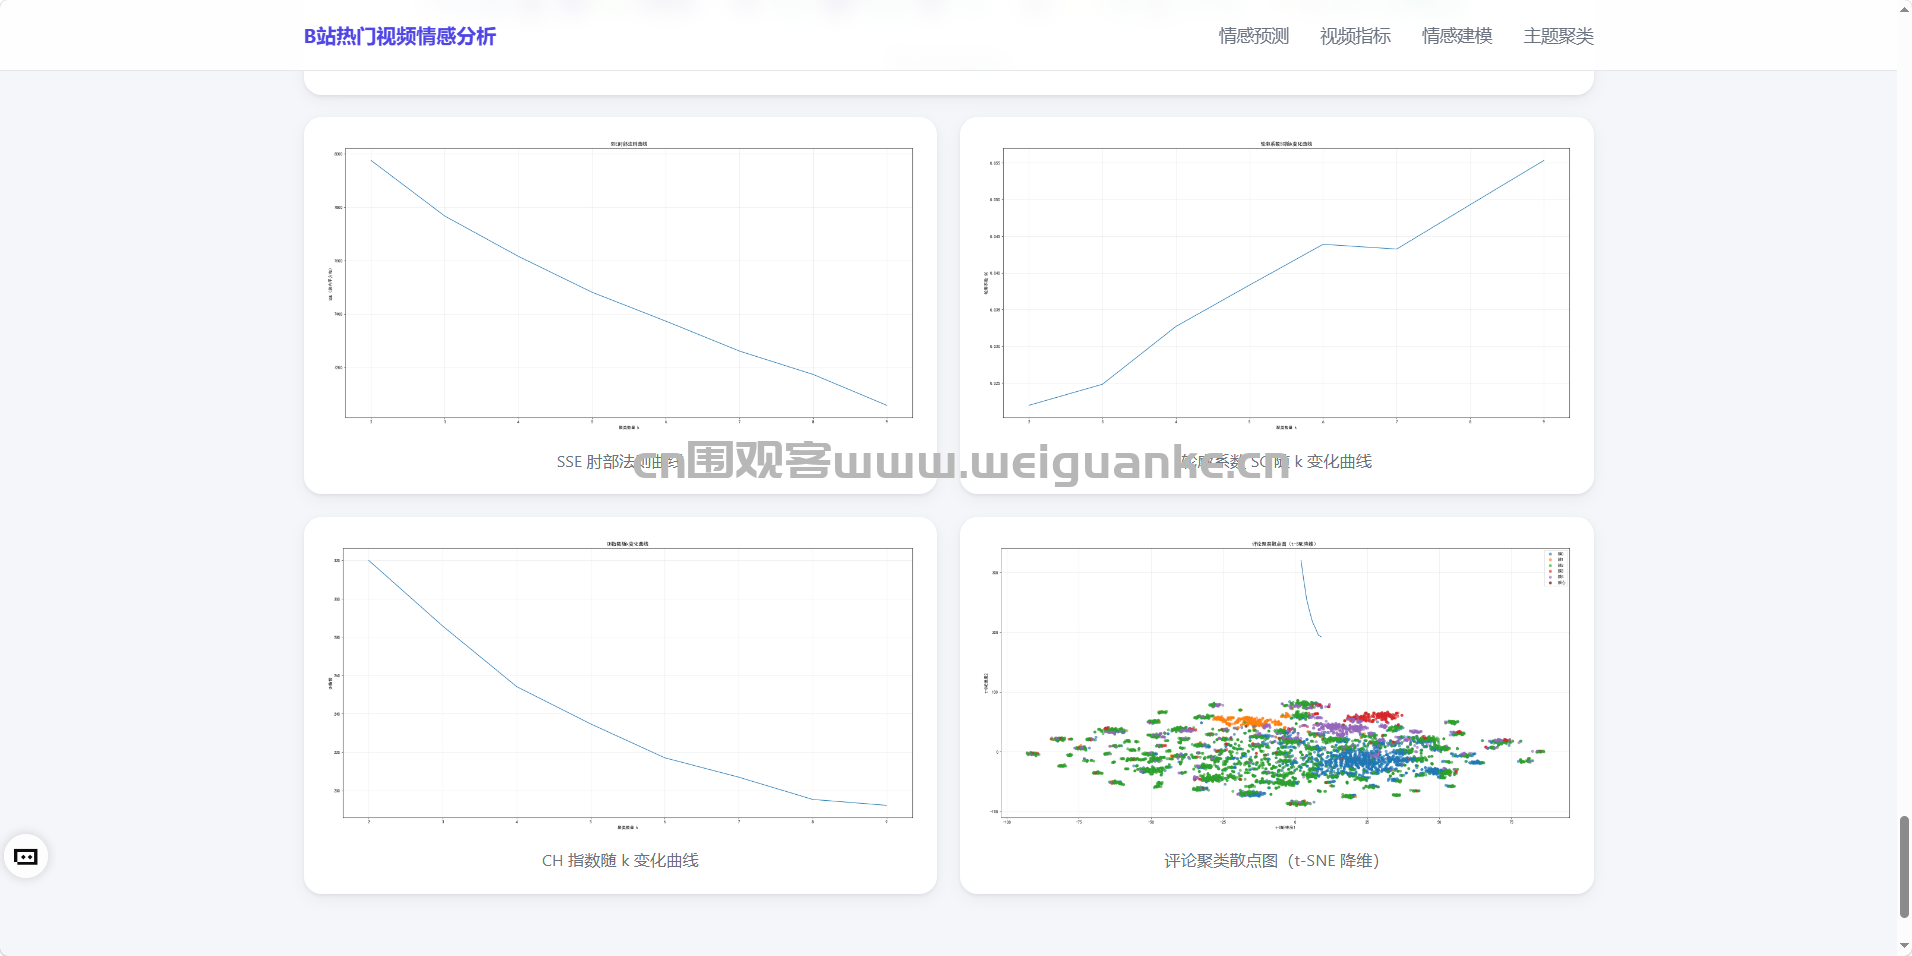
数据采集:Requests 调用 B 站视频与评论接口(wbi 签名、游标翻页),SHA-256 加盐哈希与假名映射完成数据脱敏。数据处理:Pandas、NumPy 清洗与特征构造,Jieba 分词,哈工大停用词表过滤,正则清洗。特征工程:词级 TF-IDF(1-2 元)与字级 TF-IDF(char_wb,2-3 元)双路拼接,构成 9061×435703 维稀疏矩阵。建模:Scikit-learn 实现 6 模型训练、网格搜索与分层 5 折交叉验证,XGBoost 集成对比,class_weight 处理类别不均衡;TF-IDF + TruncatedSVD + 归一化 + KMeans 完成聚类,SSE/轮廓系数/CH 指数辅助定 k,t-SNE 降维可视化。可视化:Matplotlib、Seaborn、WordCloud 输出 17 张图表。模型部署:Joblib 打包向量器与最优模型,Flask 提供预测 API 与图表路由,HTML/CSS/JavaScript 实现单页展示。
以上系统源码经过技术整理与调试,确保能正常运行