 zhe, zhuo
基于HarvestText中文文本挖掘库搭建的可视化文本分析系统-HarvestText
项目描述 基于HarvestText中文文本挖掘库搭建的可视化文本分析系统
本项目是基于 HarvestText 中文文本挖掘库搭建的可视化文本分析系统。HarvestText 是一个专注无监督、弱监督方法的中文文本预处理与挖掘工具库,项目在其原有算法能力之上新增了一个本地网页(Flask 后端加单页前端),用户在浏览器中输入文本即可完成分词、清洗、情感分析等一整套处理,无需编写代码。系统还内置《三国演义》120 章原文和 4386 个实体知识库,可直接用于演示。
项目功能
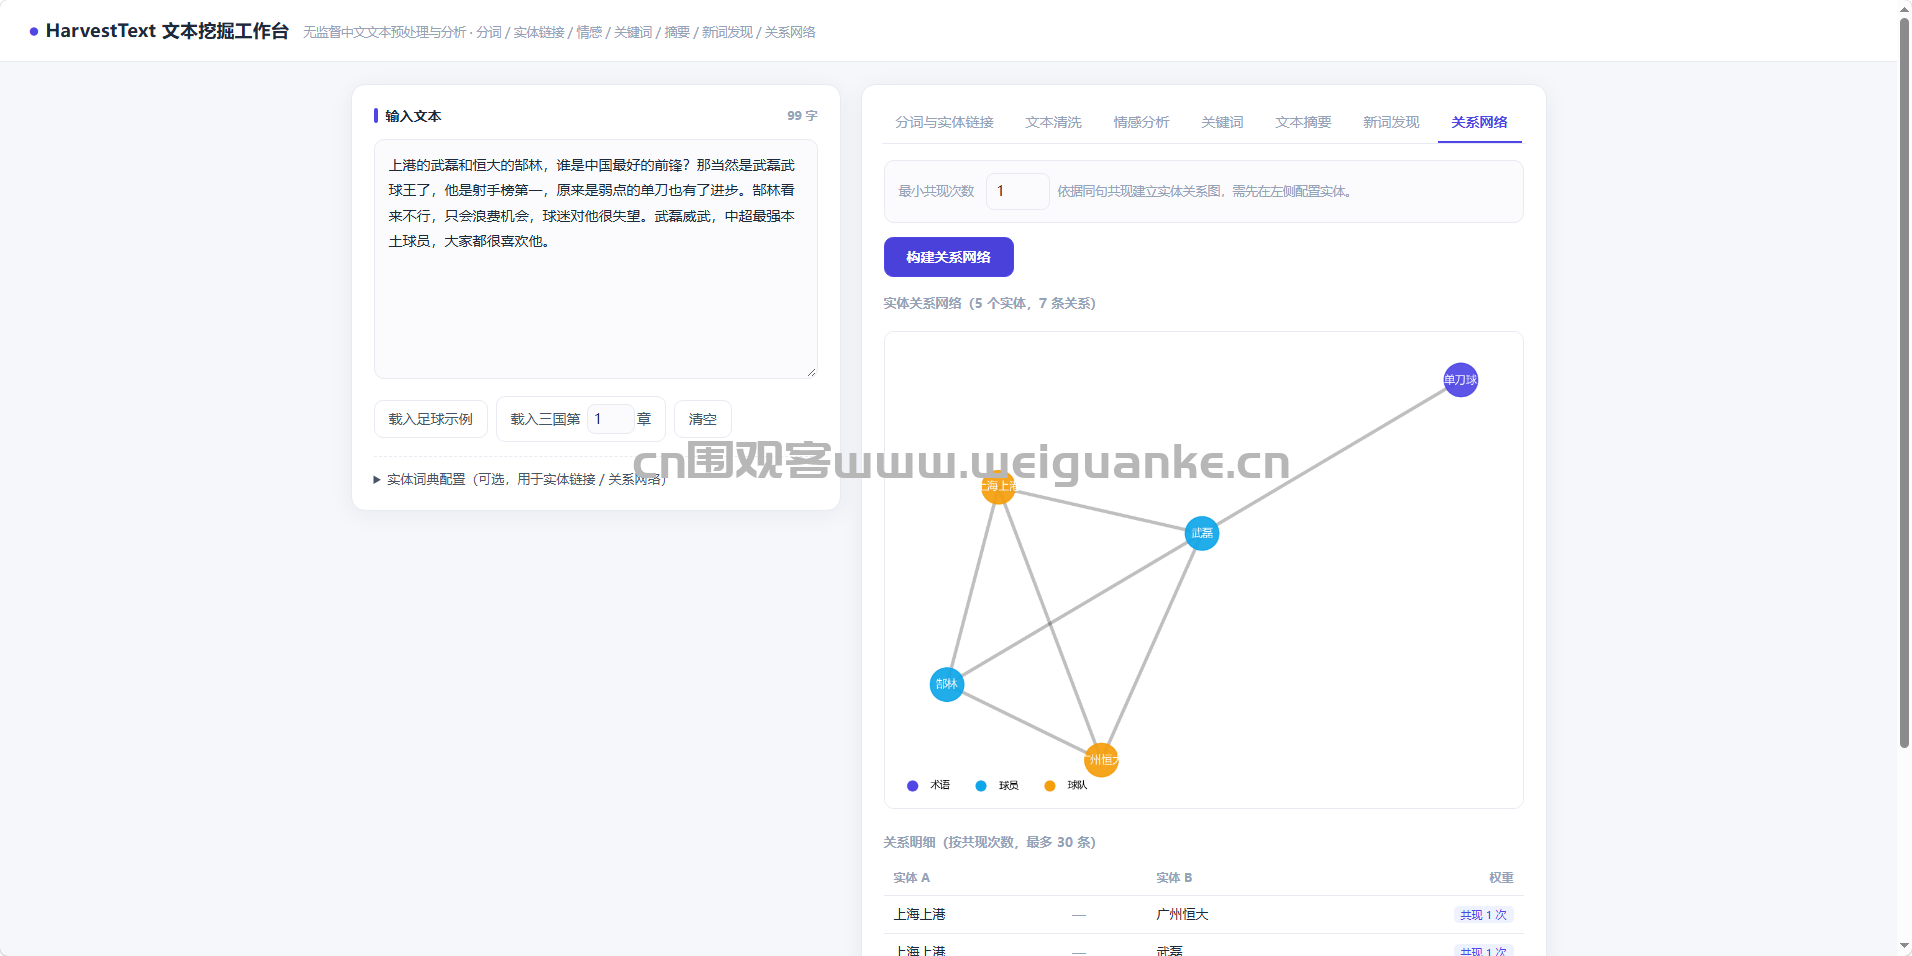
系统以标签页形式提供七项功能:一是分词与词性标注,并支持自定义实体词典,将别名、缩写自动归一为标准名;二是文本清洗,可按开关去除网址、邮箱、微博@、表情符号、HTML 标签及繁简转换等;三是情感分析,基于 SO-PMI 算法从语料中学习词语褒贬倾向,给出逐句情感分值和积极、消极词榜,支持自定义种子词或使用内置清华情感词典;四是关键词抽取,提供 jieba TF-IDF 和 TextRank 两种算法;五是文本摘要,用 TextRank 结合 MMR 去重抽取代表性句子;六是新词发现,依据词频、凝聚度和左右交叉熵等统计指标挖掘语料中的特殊词汇;七是实体关系网络,依据同句共现构建关系图并按实体类型着色出图。以上功能均无需训练模型,所有词典和语料随项目本地内置。
运行环境
操作系统为 Windows,Python 版本 3.11,依赖均通过 pip 安装,无需 GPU 和联网下载模型。系统以本地服务方式运行,启动命令为 python webapp/app.py,启动后在浏览器访问 http://127.0.0.1:5000 即可使用。
项目技术
后端采用 Python 与 Flask 框架,核心文本能力调用 HarvestText 库:分词基于 jieba,情感分析采用 SO-PMI 算法,关键词与摘要基于 TextRank,新词发现采用基于互信息和信息熵的统计算法,关系网络用 networkx 建图、matplotlib 在服务端渲染图片。前端为原生 HTML、CSS 和 JavaScript 单页实现,无外部前端依赖,界面采用靛蓝色简洁卡片风格,通过 fetch 调用后端 JSON 接口完成交互。核心代码位于 webapp/app.py 和 webapp/templates/index.html 两个文件。
以上系统源码经过技术整理与调试,确保能正常运行