 zhe, zhuo
基于AdaBoost的中文微博情感分析-AdaBoost
项目描述 基于AdaBoost的中文微博情感分析
基于AdaBoost算法的中文微博情感分析。它以微博文本为对象,做“正面 / 负面 / 客观”三类情感判别,并在朴素贝叶斯、AdaBoost、SVM 之间做对比实验,属于典型的文本挖掘与机器学习入门项目。代码规模小、依赖本地自带数据,适合学习与演示。
项目功能
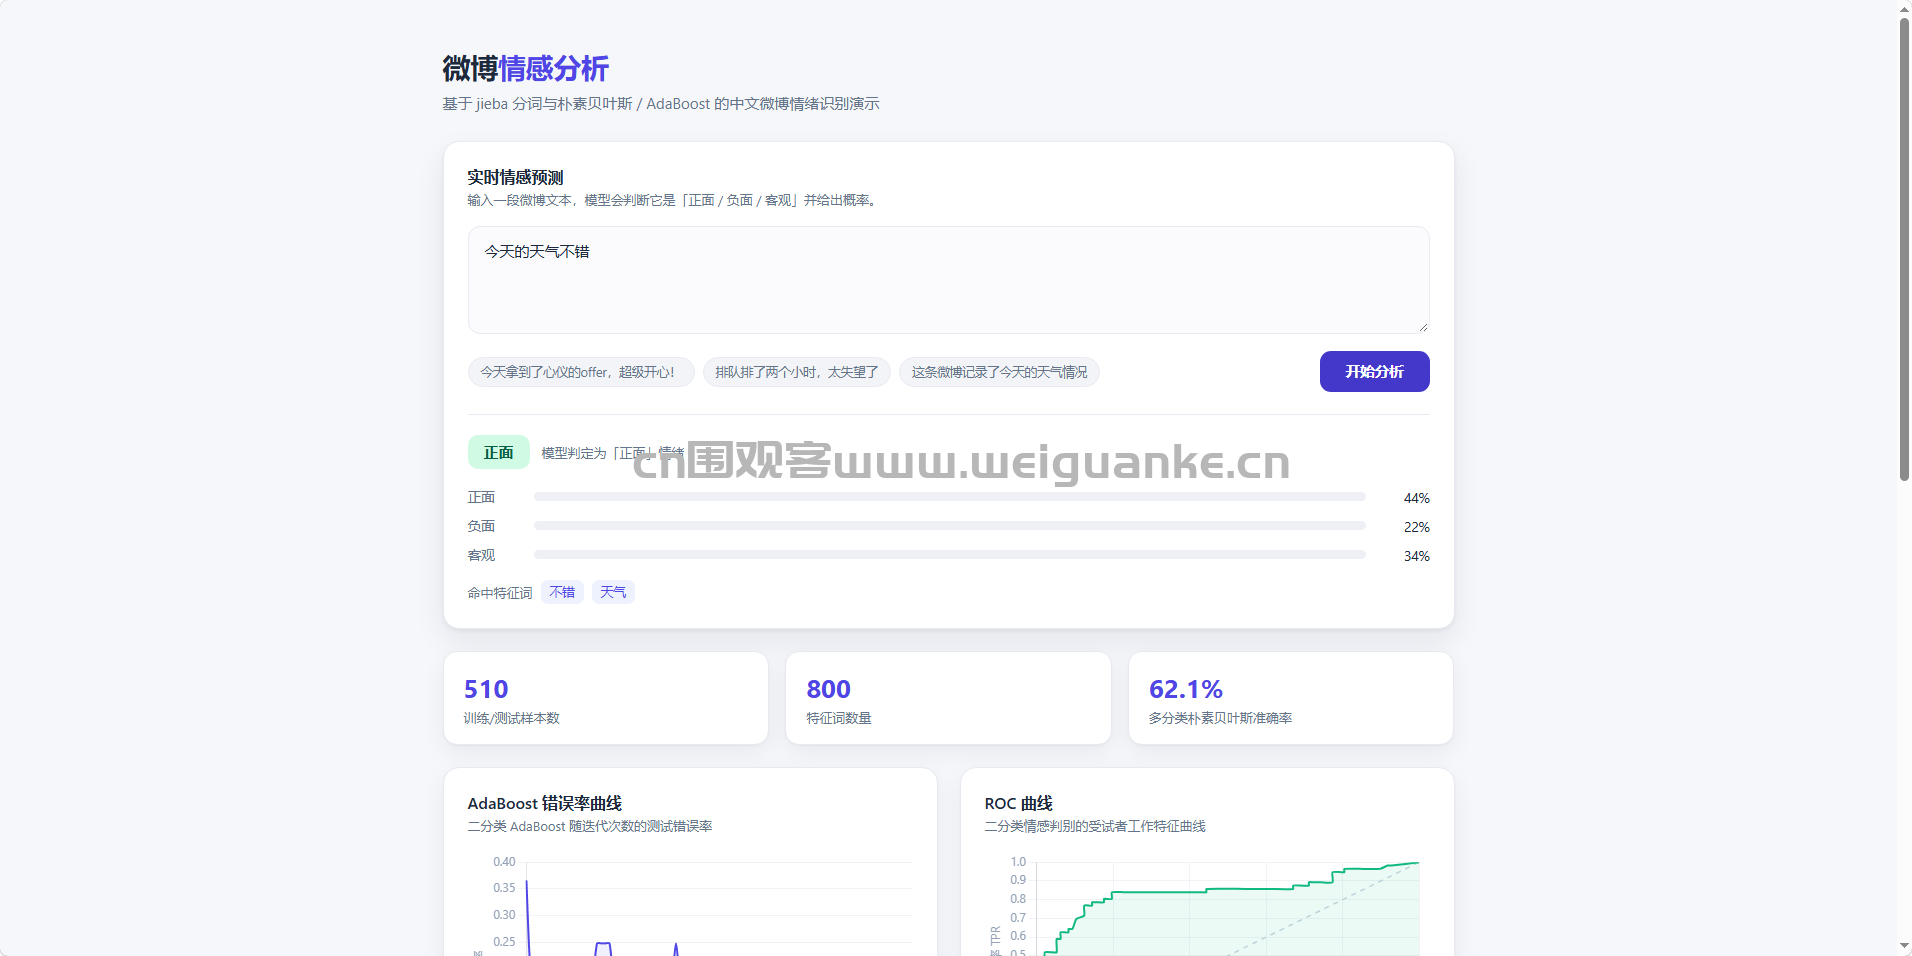
一是微博数据的采集与存储(可选 MySQL 存原始文本,from_database.py 负责取数)。二是文本预处理,包括 jieba/pynlpir 分词、去停用词、基于词频或卡方的特征词选取。三是情感分类,含朴素贝叶斯、二分类与多分类 AdaBoost(SAMME.R)以及自实现 SMO 的 SVM。四是效果评估,输出错误率曲线、ROC 曲线和训练语料词云。此外还补了一个网页,可实时输入微博文本完成情感预测并展示图表。
运行环境
Windows 系统,Python 3(实测 3.11)。核心依赖 scikit-learn、jieba、numpy;可视化依赖 matplotlib、wordcloud;数据存储依赖 PyMySQL;网页依赖 Flask。可选依赖 pynlpir 与 nltk(用于另一套分词路径,需另下 NLPIR 库与授权)。数据集与已训练模型均随项目自带,无需联网下载。
项目技术
涉及文本分类与情感分析、机器学习算法(朴素贝叶斯、AdaBoost、SVM)、特征工程(卡方检验、词频统计)、中文分词(jieba)、数据可视化(matplotlib、词云、Flask 网页)以及 MySQL 数据存储等方向,属于“文本挖掘 + 机器学习 + Web 展示”的综合实践
以上系统源码经过技术整理与调试,确保能正常运行