 zhe, zhuo
古诗词探索与互动学习平台-Flask
项目描述 古诗词探索与互动学习平台
古诗·诗境——古诗词探索与互动学习平台。以真实古诗词语料为核心,提供浏览、检索、收藏与游戏化学习,让用户从数据角度走近古典文学。纯本地运行、无需 API Key、可离线使用。
项目功能
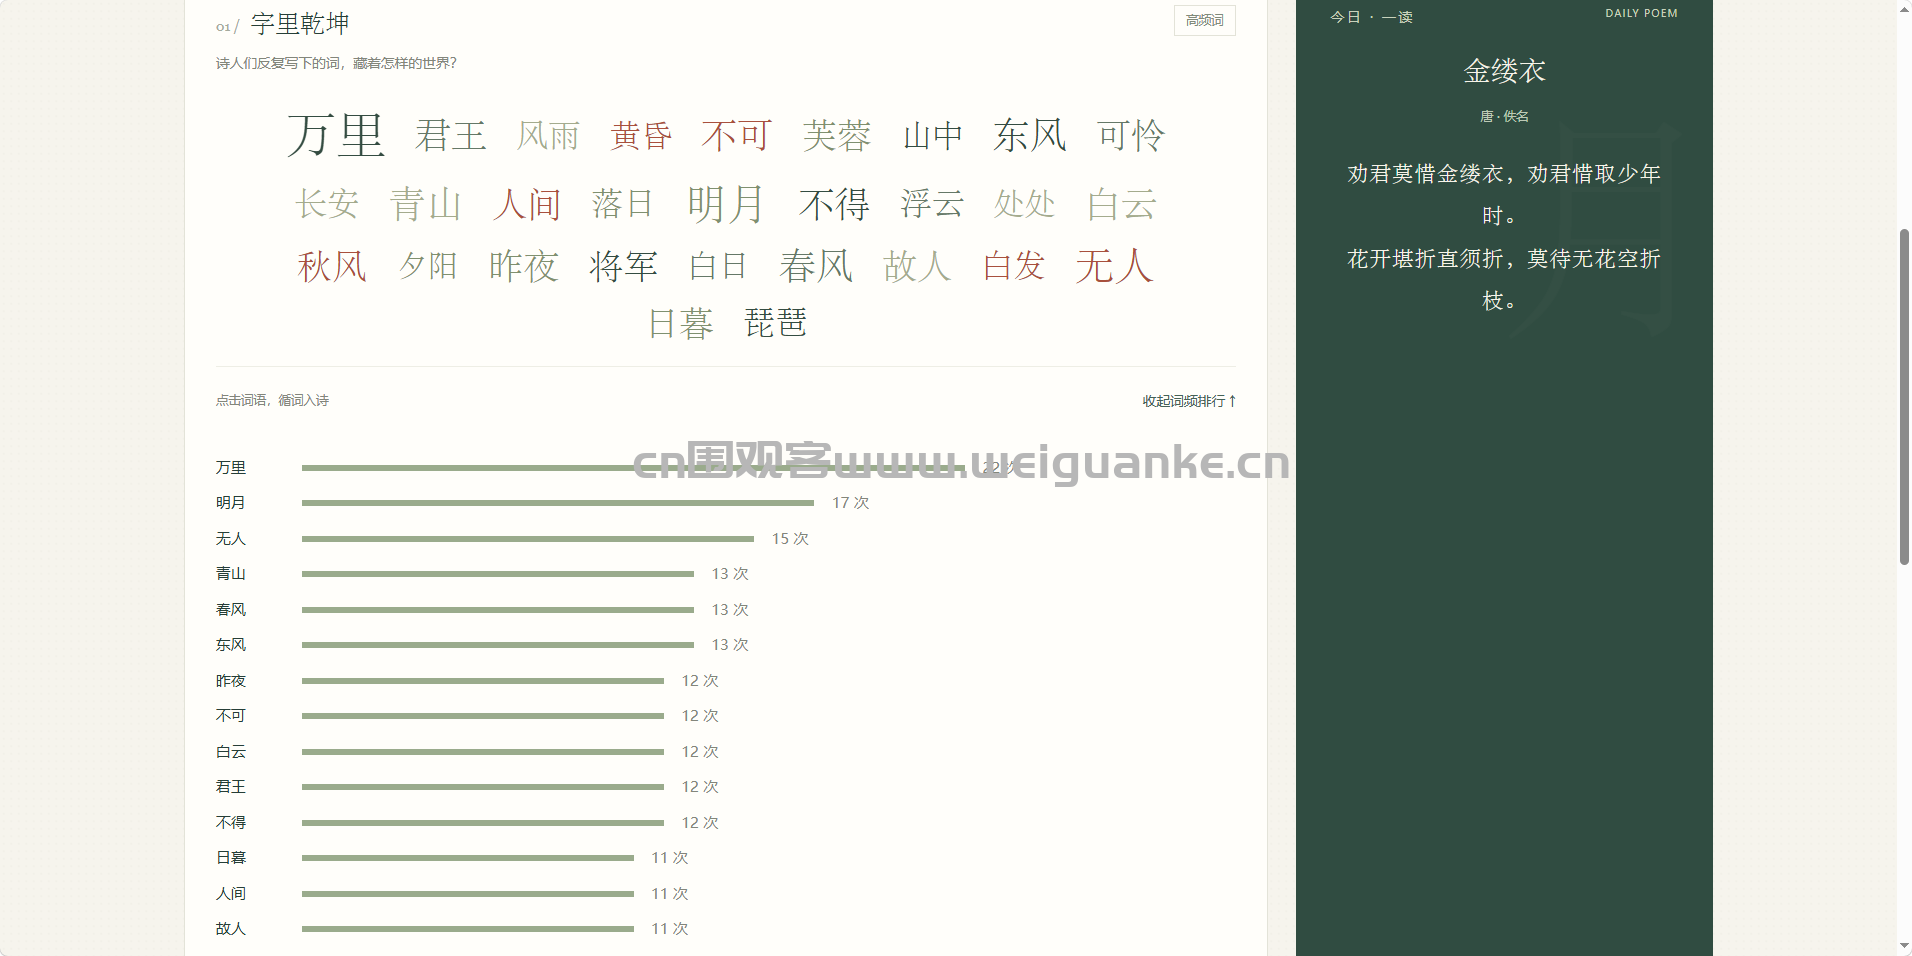
– 概览:语料统计、高频词云与词频排行、诗中四季、意象共现图,支持图表点击检索,含“今日一读”。
– 探索:按标题/作者/正文搜索,类型→选集→朝代→作者→主题联动筛选,卡片阅读、原文对照、来源追溯、随机遇诗,基于 TF-IDF 的相似作品推荐。
– 挑战:诗句填空(四选一)、飞花令(指定字/限时、繁简体规范化、出处回溯)、诗句拼图(排序还原原诗、错题重练)。
– 收藏与成绩:收藏存于浏览器 localStorage;记录轮数、最高分与错题。
– 三种玩法均支持答题反馈、原文链接与错题回顾。
运行环境
– 系统:Windows / macOS / Linux 均可。
– 语言与解释器:Python 3.11(建议 3.11)。
– 依赖库:Flask 3.1、jieba 0.42.1、opencc-python-reimplemented 0.1.7、scikit-learn 1.5+、waitress 3。
– 启动:`pip install -r requirements.txt` 后执行`python app.py` ,访问 http://127.0.0.1:5180 (Waitress 提供服务,仅绑定本机)。
– 数据:随项目附带 527 首精选(data/poems.json)即可运行;完整 36.6 万篇需下载约 1.36 GB 的 corpus.sqlite3 完整包或运行重建脚本,构建后无需联网。
项目技术
– 后端:Python + Flask 路由 API;熟练使用 SQLite 只读连接、索引与 FTS5 trigram 全文检索。
– 文本处理:jieba 分词、OpenCC 繁简转换、正则规范化与内容去重。
– 算法:scikit-learn TF-IDF 字符 1-2 元向量 + 余弦相似度做相似推荐;关键词规则标注主题与意象共现统计。
– 前端:HTML + CSS + 原生 JavaScript,ECharts 可视化;数据以 JSON API 交互。
– 数据来源:chinese-poetry 开源语料库,固定 commit 可复现构建;含来源与许可说明。
– 工程实践:单元测试(unittest)覆盖统计口径、检索筛选、飞花令、题目生成等;构建脚本先写临时库、成功再替换,保证数据可变现重建
以上系统源码经过技术整理与调试,确保能正常运行