 zhe, zhuo
中文自然语言处理工具-多项式朴素贝叶斯+k-means+DBSCAN
项目描述 中文自然语言处理工具
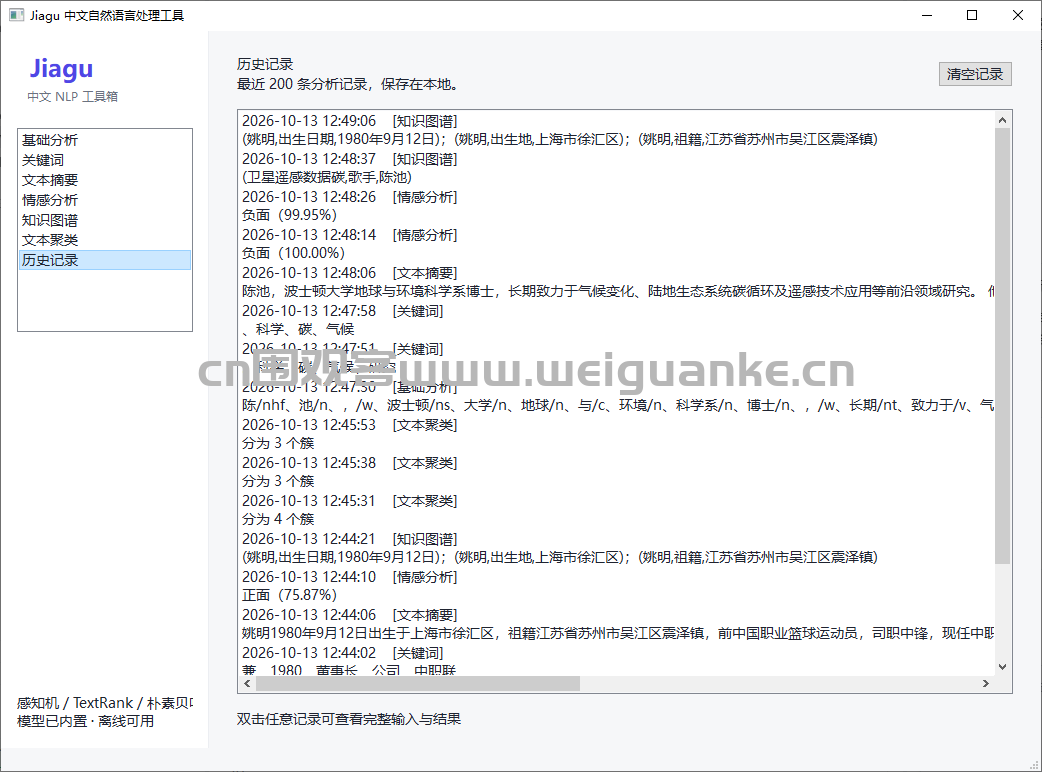
Jiagu是一个轻量级离线中文自然语言处理工具包,基于大规模语料训练的统计模型,提供分词、词性标注、命名实体识别等常用中文 NLP 能力;模型与词典全部内置,无需联网即可使用。项目另配套一个 PyQt6 桌面页面,将全部功能以图形界面形式开放。
项目功能
中文分词(支持用户自定义词典);词性标注(38 类词性);命名实体识别(人名、地名、机构名,BIO 标注);知识图谱关系抽取(主体—关系—客体三元组);TextRank 关键词抽取与文本摘要;朴素贝叶斯情感分析(正面/负面及置信度);基于信息熵与互信息的新词发现;TF-IDF 特征的 k-means / DBSCAN 文本聚类;桌面端提供上述全部功能的可视化操作与本地历史记录(最多 200 条)。
运行环境
Windows,Python 3.11(兼容 Python 3);核心功能仅依赖标准库,零第三方安装即可运行;文本聚类的 LDA 模块需 numpy;桌面页面需 PyQt6(当前环境 Qt 6.11)。模型、词典、停用词随仓库自带(约 52MB),无需下载数据集或预训练模型,完全离线运行。仅在重新训练模型时需自备 BIO 格式标注语料。
项目技术
分词采用基于感知机(Averaged Perceptron)的序列标注与词典路由;词性标注、命名实体识别、关系抽取均为感知机模型,模型以 pickle/gzip 持久化;关键词与摘要采用 TextRank 图排序算法;情感分析为多项式朴素贝叶斯;聚类为自实现的 k-means 与 DBSCAN,特征采用词频与 TF-IDF;新词发现基于词频、互信息与左右信息熵;桌面端使用 PyQt6,后台线程执行模型推理避免界面卡顿,JSON 实现历史记录本地存储。整体为纯 Python 实现,代码结构清晰,适合传统 NLP 算法学习与轻量离线文本处理。
以上系统源码经过技术整理与调试,确保能正常运行