 zhe, zhuo
基于卷积神经网络的中文手写汉字识别-cnn
项目描述 OCRCN — 中文手写单字识别项目
基于卷积神经网络的离线中文手写汉字识别项目。使用 CASIA-HWDB 手写数据集训练,能对单个手写汉字图片进行识别,覆盖 3755 个常用汉字类别。项目提供从数据加载、模型训练、微调到推理、图形界面的完整流程,当前模型验证准确率约 77%。
项目功能
模型训练:从头训练带正则化的 CNN 分类模型,支持数据增强、学习率自动衰减、早停与验证最优权重保存。
低学习率微调:在已有最优权重基础上继续精调,进一步提升准确率并避免过拟合。
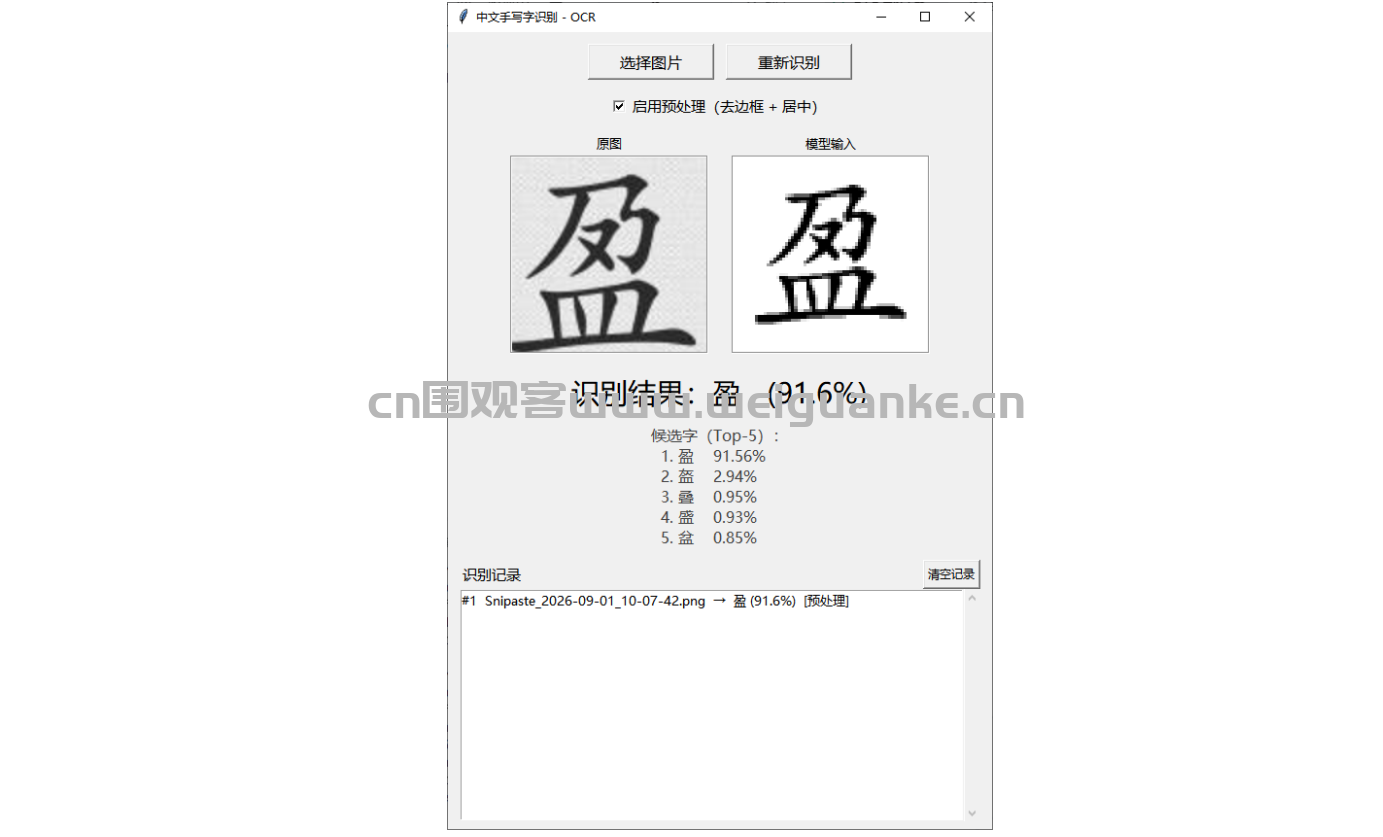
图片推理:对单张手写汉字图片输出识别结果,给出 Top-5 候选字及各自置信度。
输入预处理:自动去除截图外边框、裁出字形轮廓、居中留白、二值化归一,使输入贴近训练数据分布,显著改善带边框截图的识别效果。
图形界面:本地窗口程序,支持选图识别、Top-5 候选展示、原图与模型输入双图对比、预处理开关、识别记录列表与清空。
命令行交互:循环输入图片路径即时识别,以及批量诊断脚本。
局限:仅支持单字识别,不支持整行或多字文本;生僻且笔画密集的字识别率较低。
运行环境
操作系统:Windows 10。
Python 3.13,Anaconda 环境。
计算方式:CPU 训练与推理(无 GPU 依赖)。
需具备桌面图形环境以运行 GUI;命令行推理无此要求。
项目技术
深度学习框架:TensorFlow 2.21 / Keras 3,运行于 PyTorch 后端。
模型结构:三层卷积块(含 BatchNormalization)加全连接分类头,配合 Dropout 正则化。
数据处理:TensorFlow Datasets 读取 TFRecord,OpenCV 与 NumPy 做图像处理与预处理。
图像预处理:Otsu 二值化、外边框剥离、字形包围盒裁剪、居中留白、缩放归一。
界面与工具:tkinter 构建 GUI,PIL 负责图像显示,alfred 工具库辅助日志与环境配置。
以上系统源码经过技术整理与调试,确保能正常运行